数据库

PostgreSQL 与 Redis 实战笔记

数据库设置

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
# 连接 pgsql 并创建数据库
psql -h localhost -U username -W -c "CREATE DATABASE game_community_admin"

# 连接某一个数据库
psql -h 172.16.6.41 -p 5432 -U postgres -d game_community_admin -W

# 查询当前数据库连接数,datname:数据库名称
SELECT pid, usename, application_name, state, count(*) FROM pg_stat_activity WHERE datname = 'game_community_admin';

# 释放当前数据库全部连接,才能删库
SELECT pg_terminate_backend(pid) FROM pg_stat_activity WHERE datname = 'game_community_admin' AND pid<>pg_backend_pid();


\l	# 查看所有库
\x	# 扩展显示
\c <database>		# 切换数据库
\q	# 退出 sql 命令行
\dt	# 查看此数据库下所有表
\d <tablename>	# 查看表结构

数据库设计规范

主键设计

  • 自增主键
  • uuid
  • ulid
  • 雪花算法
  • 根据业务规则自定义生成,比如:userID + timestamp + randomNumber

雪花算法由 64bit 数字组成

  • 1-bit 不用于生成 ID(符号位)
  • 41-bit 当前时间戳(毫秒)- 指定时间的差值,可以表示 1 x 2^41 / (1000 x 3600 x 24 x 365) = 69 年的时间
  • 10-bit 可以分别表示 1 x 2^10 = 1024 台机器节点,范围 [0,1023];可以拆分为 5 位数据中心 id + 5 位工作节点 id
  • 12-bit 表示 1ms 内自动递增的序列号,1 x 2^12 = 4096 个,范围 [0,4095]。单机 1ms 可以生成 4096 个不重复的 ID

ulid 和 uuid 的对比

uuidulid
128bit128bit
36 个字符26 个字符(前 10 个字符为时间戳,后 16 个为随机数)
随机数(v4)按词典排序,但不保证同一毫秒内有序
无特殊字符(url 安全)

pgsql 主键:

1
2
3
4
5
6
7
CREATE TABLE ROLE (
  -- GENERATED BY DEFAULT AS IDENTITY(START 20000000) 指定起始值
	id INT PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
);


"id" serial PRIMARY KEY

索引

索引命名规范

命名含义
uk_<table>_<column>唯一索引
uc_<table>_<column1>_<column2>联合唯一索引
ix_<table>_<column>普通单列索引
ix_<table>_<column1>_<column2>联合索引

回表

users 包含以下列:id(主键)、name、age。

创建了一个以 name 列为索引的非聚集索引,现在执行查询 SELECT name, age FROM users WHERE name = 'John'。

由于 age 不在索引中,查询时需要先通过 name 查询出主键 id,然后在主键 id 的索引树中找到 age 的数据。

如何解决回表?

  • 聚集索引
1
SELECT name, age FROM users WHERE id = 1;
  • 覆盖索引
1
2
3
4
5
# 创建覆盖索引
CREATE INDEX idx_name_age ON students (name, age);

# 查询语句,利用覆盖索引
SELECT name, age FROM users WHERE name = 'John';

逻辑删除

如何解决唯一性约束和 is_delete 冲突的问题?

在存在唯一索引的表中添加一个 delete_id 字段,默认为 -1,删除此条记录时,将 is_delete 设为 true,同时 delete_id 设为当前行的主键 id。

假如要求 username 字段唯一,则设置 username 和 delete_id 为联合唯一索引。

1
2
3
4
5
6
7
8
9
class User(BaseModel):
    __tablename__ = 'user'
    username = db.Column(db.string(64), nullable=False, index=True)
    org_id = db.Column(db.SMALLINT, nullable=False, comment='组织id')
    delete_id = db.Column(db.INTEGER, nullable=False, default=0)

    __table_args__ = (
        db.UniqueConstraint('username', 'delete_id', name='_username_delete_id_uc'),
    )

json 和 jsonb

区别:

  • json 写入快,读取慢
  • jsonb 写入慢,读取快(jsonb 以二进制形式存储已解析好的数据)

JSONB 类型字段进行索引时,建议使用 GIN 索引。因为 GIN 索引适用于全文搜索和值匹配,可以更快地查询到符合条件的数据。而 BTree 索引只适用于比较操作和值匹配,对 JSONB 类型字段的查询效率可能会较低。

多对多

sqlalchemy 语法

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
user_roles = db.Table('sys_user_role',
    db.Column('id', db.Integer, primary_key=True),
    db.Column('user_id', db.Integer, nullable=False),
    db.Column('role_id', db.Integer, nullable=False)
)


def set_user_role(user, args):
    stmt = user_roles.insert().values(**args).returning(user_roles)
    ret = db.session.execute(stmt)
    ret = ret.mappings().one_or_none()
    db.session.commit()

如何保证幂等性

  • 乐观锁 —— 表中增加一个 version 字段,每次处理完业务后更新 version
  • 唯一索引 —— 防止 post 插入脏数据

数据库操作

查询

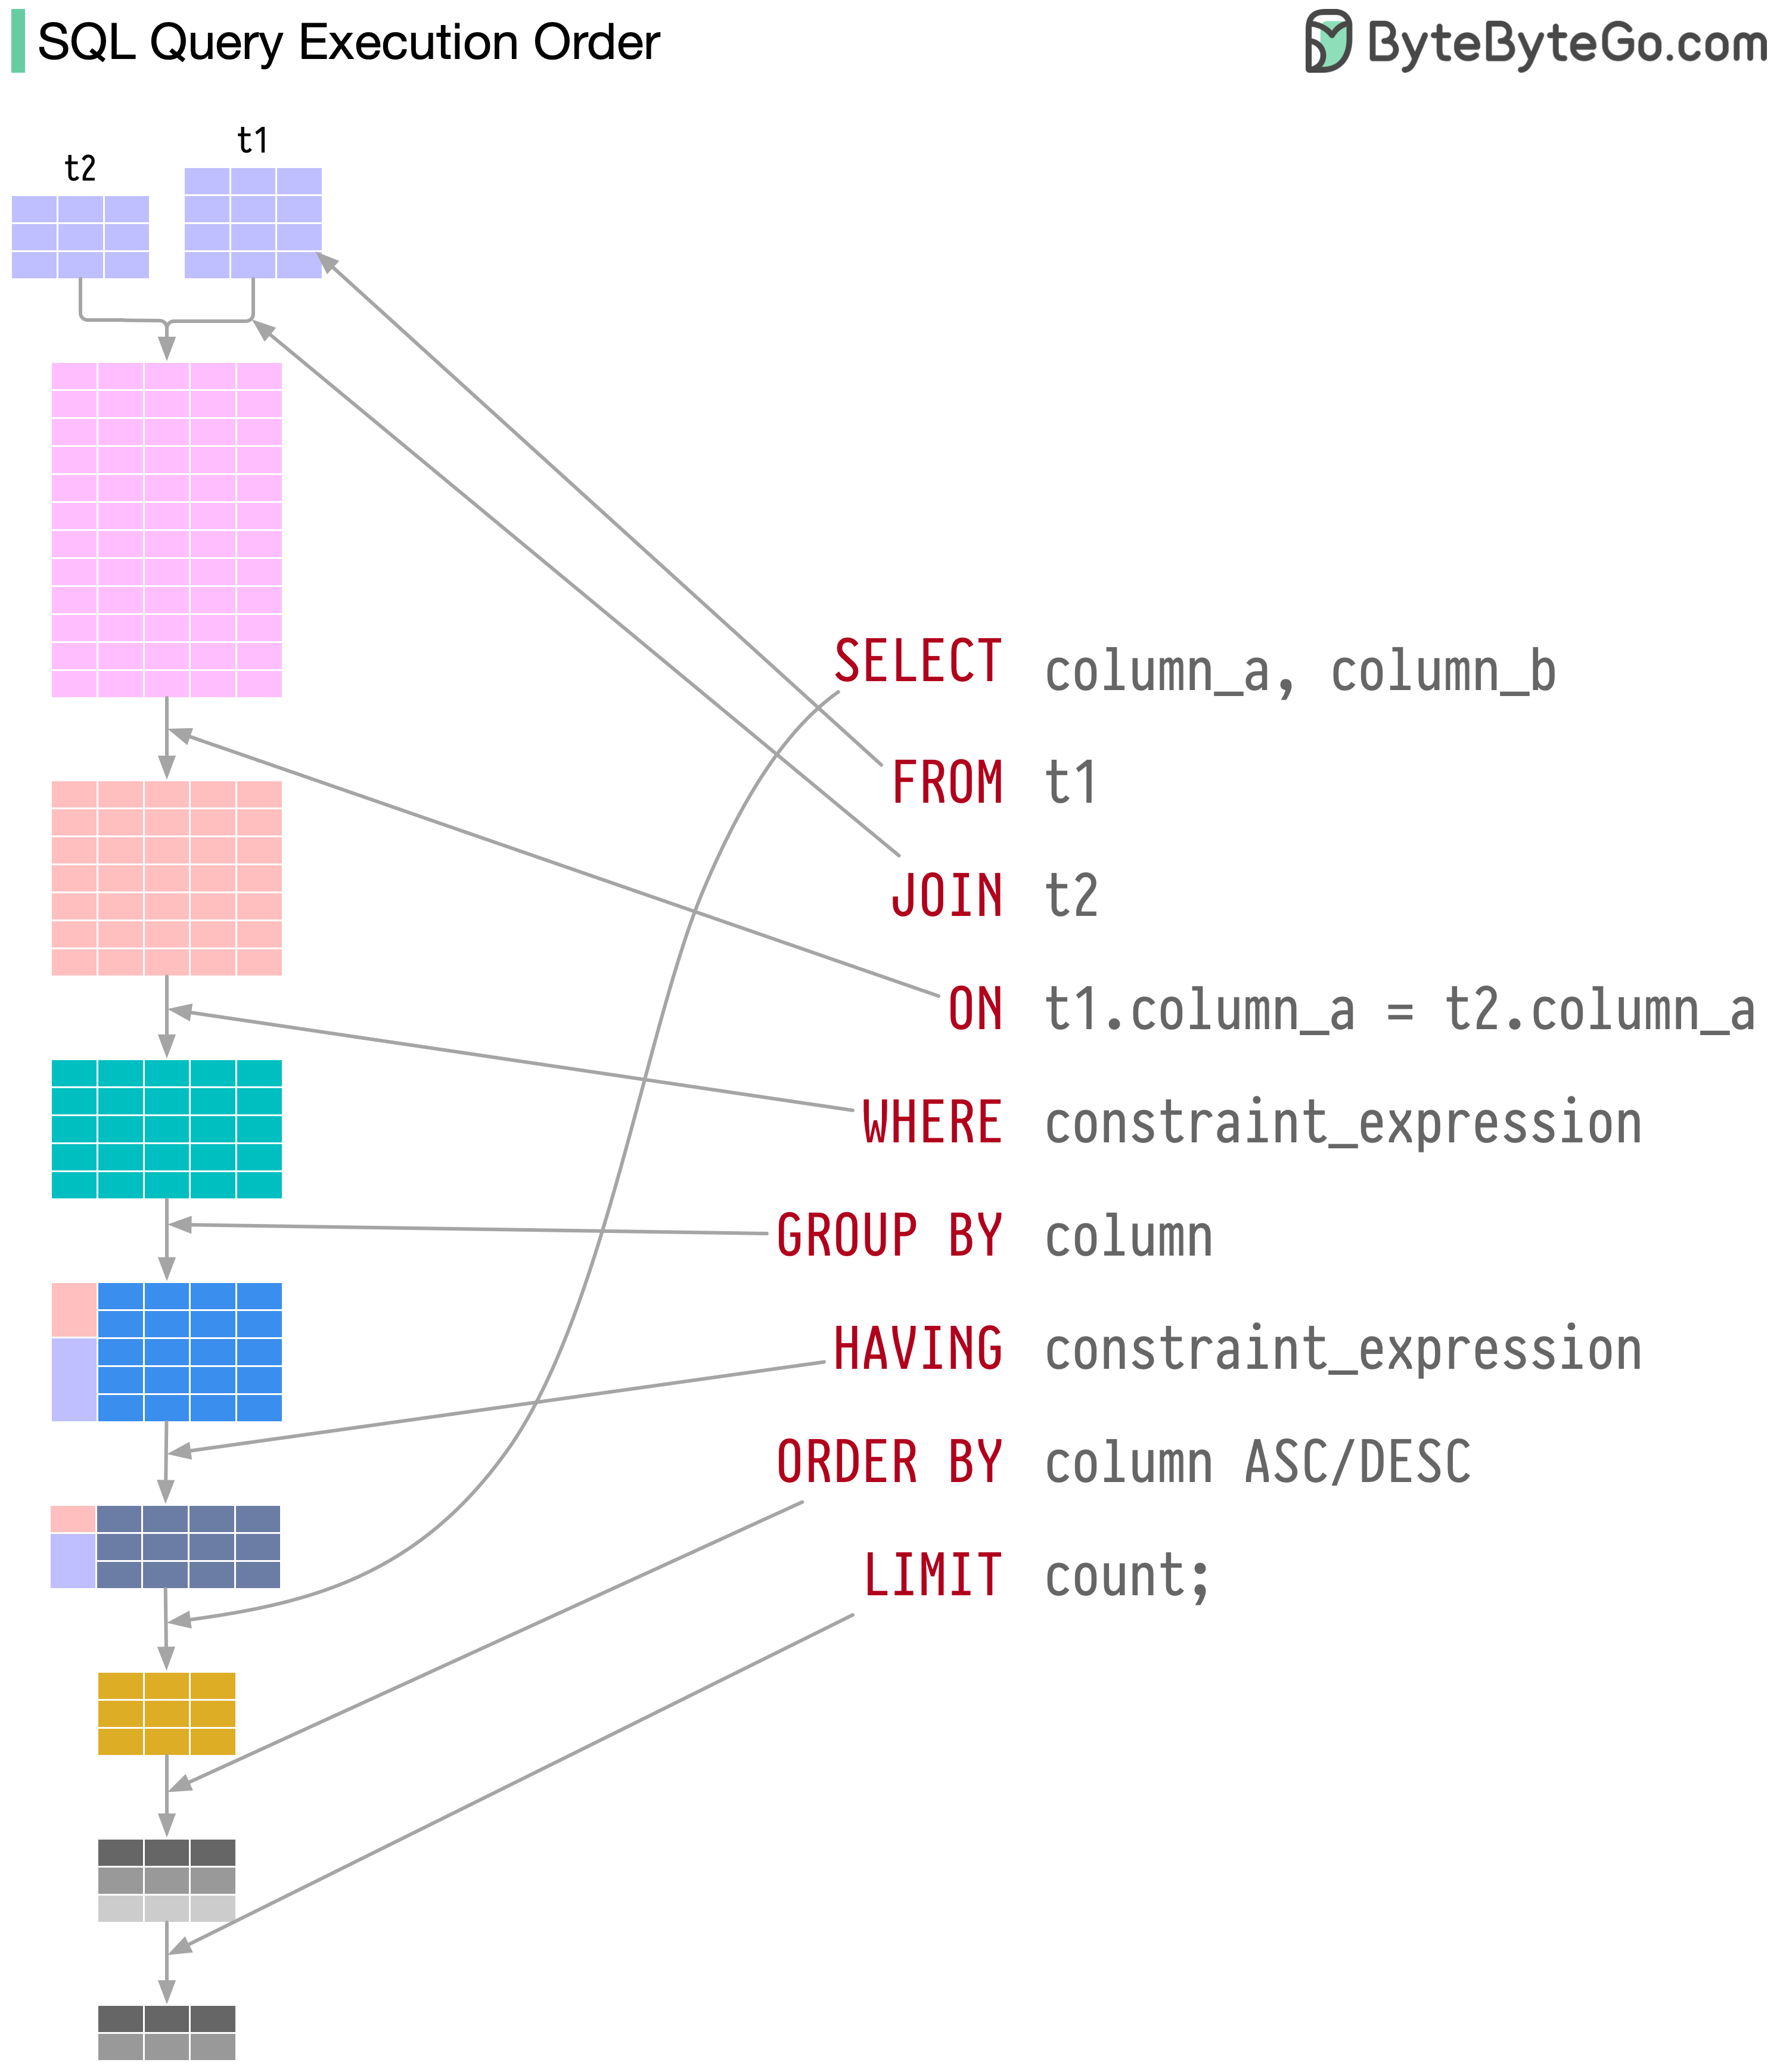
条件写在 on 和 where 的区别

  • 对于 inner join:结果无区别
  • 对于 left outer join:返回左表全部数据,右表若不满足 on 中的条件,返回 null
  • right outer join 同理

查询 json 字段类型中的某个属性

1
2
3
4
5
6
7
8
- 查询表 arguments 字段中的 name 属性
SELECT arguments->>'name' FROM table1;

- 查询 arguments 字段中的 name 属性,其中 arguments 值为数组嵌套字典格式,如 [{}, {}]
select * from table1
where exists 
  (select 1 from jsonb_array_elements(arguments) as nested_data
   where nested_data->>'name' like '%原游戏%');

深分页

查询的页数过大时会出现深分页问题,比如查询 limit 10000 offset 20,则需要查出前 100020 条然后切片截取后 20 条。

解决办法:

1
2
3
4
5
SELECT title, content
FROM post a
JOIN 
  (SELECT id FROM post ORDER BY title LIMIT 10000, 20) b
ON a.id = b.id;

判断区间是否重叠

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
SELECT * 
FROM fx_sharing_cp
WHERE daterange(start_dt, end_dt, '[]') && daterange('2023-12-21', '2023-12-22', '[]');


-- 为了保证高并发场景下数据不一致的问题,读和写最好用一条 sql 语句实现
WITH overlap_check AS (
  SELECT * 
  FROM fx_sharing_cp
  WHERE daterange(start_dt, end_dt, '[]') 
  && daterange('2023-12-21', '2023-12-22', '[]')
)
INSERT INTO fx_sharing_cp (org_id, game_id, pattern, start_dt, end_dt, create_by)
SELECT 1, 1, 1, '2023-12-21', '2023-12-22', 0
WHERE (SELECT COUNT(*) FROM overlap_check) = 0

分组聚合

GROUPING SETS 按不同维度汇总

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
SELECT
  tj_date,
  game_id,
  chl_id,
  plat,
  SUM(role_numb) AS role_numb,
  SUM(reg_numb)  AS reg_numb
FROM
  business_day
WHERE
  game_id = 2
GROUP BY
  GROUPING SETS (
    (tj_date, game_id),
    (tj_date, game_id, chl_id),
    (tj_date, game_id, chl_id, plat)
  )

更新

插入性能从低到高依次为:

executemany < execute_batch < prepare+execute_batch < execute_values

更新性能从低到高依次为:

executemany < execute_values < execute_batch < prepare+execute_batch

删除性能从低到高依次为:

executemany < execute_batch < execute_values < prepare+execute_batch

作者:xiangrumei https://www.bilibili.com/read/cv26399649/ 出处:bilibili

批量更新

使用临时表的方式:

1
2
3
4
5
6
7
8
UPDATE_POST_SCORE = """
    UPDATE post_community SET score = tmp.score
    FROM (VALUES (%s, %s)) AS tmp(id, score)
    WHERE post_community.post_id=tmp.id;
"""

from psycopg2.extras import execute_batch
execute_batch(cursor, UPDATE_POST_SCORE, result)

如果数据量大,不能一次将数据全部加载进内存,使用 itersize 或 fetchmany 分批次读取,前提是使用命名游标 named cursor。

stackoverflow 命名游标的使用分析

注意:使用命名游标情况下,如果使用 fetchmany,即使设置了 itersize,itersize 也不会生效。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
cursor = self.conn.connection.cursor(name="named_cursor")
cursor.itersize = 5000
cursor.execute(SELECT_POST_COUNTS)
data = cursor.fetchmany(20000)

now = DT.now_time()
while data:
    result = map(lambda x: (
        x[0],
        (x[1] + 2 * x[2] + 3 * x[3]) / (6 * ((round((now - x[-1].replace(tzinfo=now.tzinfo)).total_seconds() / 3600 + 2)) ** 1.8))
    ), data)
    execute_batch(self.cursor, UPDATE_POST_SCORE, result)
    data = cursor.fetchmany(20000)

删除

1
2
3
4
5
6
- 清空表数据并重置主键 id
TRUNCATE TABLE post_community RESTART IDENTITY;


- 删除列后重建表,把仍保留的列重新紧凑写入新文件,然后替换旧文件,清除物理数据
VACUUM FULL qbank_inline_label_repair_backups;

分区

分区模式:

  • range —— 基于连续范围分区
  • list —— 基于离散值分区
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
-- 让 rtime 分区

CREATE TABLE IF NOT EXISTS "event_log" (
	event VARCHAR(50),
	rtime INT NOT NULL DEFAULT EXTRACT(EPOCH FROM CURRENT_TIMESTAMP)::INT,
	distinct_id VARCHAR NOT NULL,
	user_id INT DEFAULT -1,
	args json
) PARTITION BY range (rtime);

-- 不属于任何分区的数据将会插入到默认表中
CREATE TABLE event_log_default PARTITION OF event_log DEFAULT;

创建分区表不建议使用触发器(会降低性能),因此使用脚本定时任务创建,比如当月 25 号创建下个月的分区表,具体创建逻辑据业务而定。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
from dateutil.relativedelta import relativedelta


def part_table_by_month(sub_table):

    """按月分区表"""
    now = DT.cur_dt()
    next = now + relativedelta(months=1)  # 下一个月
    next_next = next + relativedelta(months=1)  # 下下个月

    part_name = f"{sub_table}_{next.year}{next.month:02d}"
    start = DT.str2ts(f"{next.year}-{next.month}-01", "%Y-%m-%d")
    end = DT.str2ts(f"{next_next.year}-{next_next.month}-01", "%Y-%m-%d") - 1
    try:
        part_ret = part_table(sub_table, start, end)
        logger.info(f"创建分区表成功: {part_ret}")
    except Exception as e:
        logger.critical(f"创建分区表失败: {part_name}, 失败原因:{str(e)}")


def part_table(sub_table: str, start, end) -> str:
    """
    按月创建分区表(当月触发,创建下个月的)
    :param end: 分区结束范围
    :param start: 分区起始范围
    :param sub_table: 主表名
    :return: 分区表名
    """

    sql_command = f"""CREATE TABLE IF NOT EXISTS {sub_table} PARTITION OF {sub_table} FOR VALUES FROM (:start) TO (:end);"""
    try:
        db.session.execute(text(sql_command), {"start": start, "end": end})
        db.session.commit()
        return sub_table
    except Exception as e:
        db.session.rollback()
        raise e

窗口函数

函数说明
row_number()依次编号
rank()跳过并列编号:1 1 1 4
dense_rank()不跳过并列行:1 1 1 2

统计表的大小

PostgreSQL 提供了几个函数来查看表的大小,它们的区别在于统计的范围:

函数统计范围说明
pg_relation_size('表名')仅表的数据不包括索引、TOAST 数据等。
pg_table_size('表名')表的数据 + TOAST包括表数据、TOAST 数据、空闲空间映射和可见性映射,但不包括索引。
pg_total_relation_size('表名')表的数据 + 索引 + TOAST这是最全面的统计,包含了表本身及其所有索引和 TOAST 数据的总大小。
pg_indexes_size('表名')仅索引返回与表关联的所有索引的总大小。

注意:上述函数中的 '表名' 参数格式为 '模式名.表名',例如 'public.users'。为了便于阅读,这些函数常与 pg_size_pretty() 函数连用,将字节数转换为 kB、MB、GB 等人类易读的格式。

常用查询示例

  1. 查询特定表的总大小(包含数据和所有索引)
1
SELECT pg_size_pretty(pg_total_relation_size('你的模式名.你的表名')) AS 总大小;
  1. 查询特定表的数据大小(不包含索引)
1
SELECT pg_size_pretty(pg_relation_size('你的模式名.你的表名')) AS 数据大小;
  1. 查询数据库中所有表的大小,并按从大到小排序
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
SELECT
    schemaname AS 模式,
    tablename AS 表名,
    pg_size_pretty(pg_total_relation_size(schemaname||'.'||tablename)) AS 总大小
FROM
    pg_tables
WHERE
    schemaname NOT IN ('information_schema', 'pg_catalog')
ORDER BY
    pg_total_relation_size(schemaname||'.'||tablename) DESC;

统计数据库的大小

统计数据库大小主要使用 pg_database_size() 函数。

函数说明
pg_database_size('数据库名')返回指定数据库的总大小。

常用查询示例

  1. 查询特定数据库的大小
1
SELECT pg_size_pretty(pg_database_size('你的数据库名')) AS 数据库大小;
  1. 查询 PostgreSQL 服务器上所有数据库的大小,并按从大到小排序
1
2
3
4
5
6
7
SELECT
    datname AS 数据库名,
    pg_size_pretty(pg_database_size(datname)) AS 大小
FROM
    pg_database
ORDER BY
    pg_database_size(datname) DESC;

补充:使用 \l+ 和 \dt+ 命令

如果你通过 psql 命令行工具连接数据库,也可以使用以下两个快捷命令:

  • \l+:列出所有数据库,并附带它们的大小、表空间和描述等信息。
  • \dt+ 表名:显示指定表的详细信息,其中就包括大小。

数据库备份

1
2
3
4
5
6
7
8
# 备份数据库,排除`community_log`和 `users`表,仅导出数据不包括结构
pg_dump -h <host> -p <port> -U <user> -d <database> -F p --data-only -T community_log -T users > /data/backup.sql

# 导出某张表
pg_dump -h host -p port -U username -s -t tablename dbname > struct.sql

# 目标数据库上执行 sql 脚本
psql -h <host> -p <port> -U <user> -d <database> -W -f /data/backup.sql

Redis

配置

1
2
3
4
5
6
7
# 生成 10 位 base64 编码的密码并以标准字符集输出
openssl rand 10 | openssl base64 -A
vim /etc/redis.conf, 取消 requirepass 行的注释,修改后面的值
sudo systemctl restart redis

# 开启过期 key 事件监听(会有一定的额外消耗)
config set notify-keyspace-events Ex

持久化策略

以下是 Redis 的两种持久化策略及其默认配置的对比表格:

持久化策略RDB (Redis Database)AOF (Append Only File)
原理定时生成内存快照(二进制文件)记录所有写操作命令(文本追加日志)
触发方式手动触发 / 按配置的时间间隔自动触发实时记录(可配置同步频率:每秒/每次写入)
文件格式紧凑的二进制文件(.rdb)可读的文本文件(.aof)
恢复速度快(直接加载快照)慢(需重放所有命令)
数据安全性可能丢失最后一次快照后的数据更高(取决于同步频率,最多丢失 1 秒数据)
文件体积小(仅最终数据状态)大(持续增长,需定期重写优化)
性能影响生成快照时可能阻塞主线程写入日志对性能影响较小(但同步频繁时会降低吞吐量)
默认启用是(Redis 默认持久化方式)否(需手动配置)

关键说明

  1. 默认策略:Redis 默认启用 RDB 持久化,会在以下条件满足时自动生成快照(可通过 save 配置修改):
1
2
3
save 900 1     # 900秒(15分钟)内至少1个key变化
save 300 10    # 300秒(5分钟)内至少10个key变化
save 60 10000  # 60秒内至少10000个key变化
  1. 混合持久化(Redis 4.0+):可同时启用 RDB 和 AOF(aof-use-rdb-preamble yes),结合两者优势:

    • AOF 文件前半部分是 RDB 格式的快照,后半部分是增量命令。
  2. 如何选择:

    • RDB 适合备份、灾难恢复(快速加载)。
    • AOF 适合需要高数据安全性的场景(如金融交易)。

配置示例

1
2
3
4
5
6
# 启用 RDB(默认已启用)
save 900 1

# 启用 AOF
appendonly yes
appendfsync everysec  # 每秒同步一次(平衡性能与安全)

通过 INFO PERSISTENCE 命令可查看当前持久化状态。

如何保证数据一致性?

非强一致性场景:先更新数据库,再删除缓存(加分布式锁保证线程安全)

强一致性场景:延迟双删

  1. 先删缓存,然后更新数据库,延迟删除缓存
  2. 先更新数据库,删缓存,延迟删缓存

第 2 种更安全。

休眠时间 = 读业务逻辑数据的耗时 + 几百毫秒

异步缓存写入:先更新缓存,再异步更新数据库(适用于动态数据且一致性要求不高的场景,如点赞、浏览等)

Redis 分布式锁

redlock 算法

https://redis.io/docs/manual/patterns/distributed-locks/#the-redlock-algorithm

  1. 以毫秒为单位获取当前时间 T1。
  2. 尝试在所有 N 个实例中依次获取锁,在所有实例中使用相同的键名和随机值,并且会设置一个比锁的有效时间小的超时时间。例如,如果自动释放时间为 10 秒,那么超时时间可以在 5-50 毫秒之间。这样可以防止客户端在尝试与宕机的 Redis 节点通信时长时间处于阻塞状态:如果某个实例不可用,我们应尽快尝试与下一个实例通信。
  3. 客户端获取当前时间戳 T2。如果客户端能在大多数实例(至少 3 个)中获取锁,且 T2 - T1 < 锁的有效时间时,才认为获取了锁。
  4. 如果锁已被获取,则其有效时间被认为是初始有效时间减去步骤 3 计算出的已用时间。
  5. 如果客户机因某种原因未能获取锁(要么无法锁定 N/2+1 个实例,要么有效时间为负),它将尝试解锁所有实例(甚至是它认为无法锁定的实例)。

如何续期?

额外启动一个守护线程定时去轮巡当前锁是否已释放。

缓存击穿 & 缓存血崩

缓存击穿:单个热点 key 失效 + 并发访问,导致这些请求全部涌入数据库中

缓存穿透:缓存和 db 都没有数据 + 并发访问

缓存雪崩:批量 key 失效 + 并发访问,导致大量请求涌入数据库

解决缓存击穿

  • 热点数据设置热度时间窗口,时间窗口内,延长缓存时间
  • 多级缓存
  • 设置较长的过期时间

解决缓存穿透

  • 使用布隆过滤器判断元素是否存在,不存在则直接返回
  • 空对象缓存:不存在的数据存储为空对象缓存
  • 延迟双判:查询请求穿透到 db 时,先在 db 查询,db 也没有,则将空结果缓存,设置一个较短的过期时间
  • 缓存预热
  • 限流

解决缓存雪崩

  • 多级缓存
  • 缓存预热
  • key 设置随机过期时间

应用

HyperLogLog 统计 UV

HyperLogLog (HLL) 是一种基数估计算法,用于统计一个集合中不重复元素的个数。

我们先来看一个简单的例子:假设有一个篮子,里面装满了彩色的球,每个球上都有一个不同的数字。现在我们想知道篮子里有多少种不同的数字,但是我们不希望一个个球拿出来去重,因为球可能有很多甚至无限个。

具体原理如下:

  1. 创建一个定长的位数组,里面的每个位都初始化为 0。
  2. 对于集合中的每个元素,通过哈希函数将其映射为一个二进制字符串,并取这个字符串中特定的一段作为索引。
  3. 在位数组对应的索引位置上,记录该位置出现的最大前导零的长度。
  4. 根据位数组中最大前导零的长度,估算出集合中不重复元素的个数。

HyperLogLog 的核心思想是利用哈希函数的随机性和最大前导零的长度分布来估计不重复元素的个数。当位数组中的某个位置记录的最大前导零长度比较大时,说明这个位置对应的哈希值较小的元素较多,因此可以推测集合中不重复元素的个数也相对较多。

由于使用了哈希函数和概率统计,HyperLogLog 的估计结果可能会有一定的误差,但在实际应用中,这个误差通常是可接受的。

HyperLogLog 是一种通过概率统计估计集合中不重复元素个数的算法,它以极小的内存开销来实现高效的基数估计。

模拟:http://content.research.neustar.biz/blog/hll.html

命令

  • PFADD PFADD key [element [element ...]]
  • PFCOUNT PFCOUNT key [element [element ...]]
  • PFMERGE PFMERGE key [element [element ...]]

incr 文章浏览量计数

hincrby、incrby

bitmap 位图

setbit key offset value

最大支持 512mb = 2^32 位

  • 账号封禁

一个封禁能力对应一个 bitmap,比如 banned:login,用户 id 作为偏移量。

封禁登录:setbit banned:login 1000018 1

解禁登录:setbit banned:login 1000018 0

判断是否被封禁:getbit banned:login 1000018

如果用户 id 较大,可对 uid 哈希计算,或按一定规则处理,比如数据库中 uid 从 1000000 自增,那么偏移量可设为 uid - 1000000,其中偏移量是从 0 开始的。

scan 扫描匹配的所有键

相比较于 keys 命令阻塞式命令,大 key 会存在问题;scan 命令是一个基于游标的迭代器,每次迭代 count 返回一个游标继续下一次迭代,不过会存在重复值,需要去重。

1
2
3
4
5
6
7
def scan_uk(pattern, count=None):
    """使用 scan command 匹配 keys 并去重"""
    uq_keys = set()
    for key in client.scan_iter(match=pattern, count=count):
        if key not in uq_keys:
            uq_keys.add(key)
            yield key

其他

实现数据表格拖拽排序

1. 全量更新 —— 添加一个 sort 字段,表示序号

  • 拖拽节点:最简单的方式是直接更新全部节点新的 sort 值(一般前端框架可以获取到更新后的序号),也可以只传这两个节点 id,服务端去计算 sort,更新这两个节点之间的记录的 sort。如果是前往后拖,则 sort = sort - 1,否则 sort = sort + 1
  • 删除节点:其后的节点全部前移一位
  • 新增节点:新节点的 parent_id = max(sort) + 1
  • 适用场景:数据量小,拖拽操作不频繁

2. 单链表(邻接表) —— 添加一个 parent_id 字段,指向其前驱节点

  • 拖拽节点:需要交换这两个节点对应的 parent_id 值以及其前驱和后继节点的 parent_id 值
  • 删除节点:更新其直接后继节点的 parent_id 值
  • 新增节点:如果是尾插法,parent_id = 链表最后一条记录的 id;如果是头插法 parent_id = null
  • 适用场景:数据量中等,频繁拖拽,不适用于分页场景(因为获取父子节点关系必须按序遍历全部数据)

3. 双链表 —— 添加 pre 和 next 字段

交换两个节点:考虑以下几种情况

情况一:cur 在前,dest 在后

  • 节点相邻

     1
     2
     3
     4
     5
     6
     7
     8
     9
    10
    11
    
    # 更新当前对象的前驱节点的后继
    cur.pre.next = dest
    # 更新目标对象的后继节点的前驱
    dest.next.pre = cur
    
    # 更新目标对象前驱及后继
    dest.pre = cur.pre
    dest.next = cur
    # 更新当前对象前驱及后继
    cur.pre = dest
    cur.next = dest.next
    
  • 节点不相邻

     1
     2
     3
     4
     5
     6
     7
     8
     9
    10
    11
    12
    13
    14
    15
    
    # 更新当前对象的前驱节点的后继
    cur.pre.next = dest
    # 更新目标对象的后继节点的前驱
    dest.next.pre = cur
    # 更新当前对象的后继节点的前驱
    cur.next.pre = dest
    # 更新目标对象的前驱节点的后继
    dest.pre.next = cur
    
    # 更新目标对象前驱及后继
    dest.pre = cur.pre
    dest.next = cur.next
    # 更新当前对象前驱及后继
    cur.pre = dest.pre
    cur.next = dest.next
    

情况二:cur 在后,dest 在前

  • 节点相邻

    1
    2
    3
    4
    5
    6
    7
    
    cur.next.pre = dest
    dest.pre.next = cur
    
    dest.pre = cur
    dest.next = cur.next
    cur.pre = dest.pre
    cur.next = dest
    
  • 节点不相邻

    1
    2
    3
    4
    5
    6
    7
    8
    9
    
    cur.next.pre = dest
    dest.pre.next = cur
    cur.pre.next = dest
    dest.next.pre = cur
    
    dest.pre = cur.pre
    dest.next = cur.next
    cur.pre = dest
    cur.next = dest.next
    

如何判断双链表中任意两个节点的先后关系?

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def find_order(self, n1: QueryT, n2: QueryT, filters: list = None):
    """
    比较两个节点的顺序
    :param n1:
    :param n2:
    :param filters:
    :return:
        1 n1在前
        -1 n1在后
        None 节点不满足链表关系
    """

    if filters is None:
        filters = []

    data = self.model.query.filter(*filters).all()
    nodes = {self.get_cur(item): item for item in data}

    cur = n1
    while cur:
        if self.get_cur(cur) == self.get_cur(n2):
            return 1
        cur = nodes.get(self.get_next(cur))

    cur = n2
    while cur:
        if self.get_cur(cur) == self.get_cur(n1):
            return -1
        cur = nodes.get(self.get_next(cur))

使用 pgsql 递归查询:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
WITH RECURSIVE cte AS (
    SELECT * FROM avatar_management
    WHERE pre_id IS NULL and community_id=8  -- 找到链表的起始节点,即 pre_id 为空的节点
    UNION
		SELECT am.*
		FROM avatar_management am 
		JOIN cte ON am.pre_id = cte.id  -- 通过递归连接找到下一个节点
		where am.community_id=8
)
SELECT * FROM cte;

4. 闭包表 —— 需要建立额外一张表 TreePath,使用空间换时间策略

包含 3 个字段,(ancestor,descendant)设为联合主键,其中每一个字段都是指向 target_id 的外键,level 用来表示层级深度:

  • ancestor
  • descendant
  • level(可选)

分页查询

Redis zset 分页

场景举例:评论分页(按热度排序)

由于热度值是动态变化的,且不能暴露给客户端,传统分页必然不行,zset 可以很好解决这个问题。stamp 是数据快照标识(比如当前时间戳),可保证在分页过程中的数据完整性和一致性,每次发布新评论或删除评论都是操作的最新数据快照缓存,有效期设为 6h 或 8h。

查询参数:

  • last —— 前一次查询返回的游标,即下次查询的起始索引
  • limit —— 分页大小
  • stamp —— 数据快照标识(比如当前时间戳)

缓存 key 设计:comment:${资源类型}_${资源id}_${排序方式}_${数据版本标识}

key 存在才可操作,并且需要设置一个合适的 ttl,集合元素个数最好不要超过 5000。

相关命令

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
ZREVRANGE 按分数值递减返回指定区间内的成员,相同 score 的 member 按字典序的逆序排列
>> ZREVRANGE key start stop [WITHSCORES]

向集合中插入元素,评论 id 作为 member,热度值作为 score
>> ZADD key score1 member1 score2 member2 ...

删除元素
>> ZREM key member

查询
>> zrevrange key last last + limit - 1

获取总数
>> zcard key
1
2
3
4
# 获取最新 key
max(keys, key=lambda x: int(x.split("_")[-1]))

last = last + limit if last + limit < total else None

注意:缓存只保存评论 id,且只有当缓存 key 存在才插入

游客模式

首次使用 app 时服务端分配一个 uid,status 设为 -1 表示游客。

  • 使用未占用的手机号或三方账号登录时,uid 不变,修改状态为 1,数据不合并
  • 使用已占用的手机号或三方账户登录时,uid 更换为新登录账号的 uid(相当于切换账号),数据不合并